01 — PROFILE
我让 AI不只会生成,还能够交付。
从需求定义、Agent 边界到 QA 与交接,我负责把复杂工作推进到结果可验证。
固定手模 · 多线 Agent · 失败重试 · QA · 页面交付
01 / 我的核心优势
我不是把 AI 当成答案,而是把它变成可交付的工作系统。
我的价值不在于让 AI 多做,而在于定义清楚目标、控制过程风险,并让结果经得起验收。
需求转译 / TRANSLATE
- 业务目标
- 任务范围
- 不可变约束
- 验收标准
- 优先级
过程控制 / CONTROL
- 上下文管理
- Prompt 版本
- 任务状态
- 成本与风险
- 失败恢复
交付负责 / OWN
- 判断与决策
- 结果审查
- 回归验证
- 人工 QA
- 最终交付
我擅长的不是让 AI 多做,
而是让团队知道它为什么做、做到哪一步、是否可以交付。
02 / 优势 × 作品证据
优势不是自我评价,
每一项都有项目证据。
01我如何把模糊需求变成可执行目标?产品经理P0 / P1 风险分级 → 不可变约束 → 验收标准F-003 · F-01102我如何让批量任务在失败后继续?产品运营状态机 → 错误分类 → 重试 → QA → 发布F-005 · F-00703我如何让复杂链路真正被人使用?UI / 体验商品页、试戴入口与运营界面形成连续路径F-00804我如何控制 Agent 不越界?AI 辅助开发只读审计 → Scope Lock → 隔离修复 → Fact HandoffF-004 · F-01105AI 说完成了,我如何确认?软件测试自动测试 + 对抗式审查 + 回归 + 人工终审F-002 · F-003 · F-007
用固定手模与多线 AI,
替代逐款重复拍摄。
客户情况:FINGLOW 是初创穿戴甲品牌,需要为 50+ SKU 持续生产统一风格的商品内容,但预算与团队规模有限。
真实痛点:逐款重新找真人手模、佩戴甲片、组织摄影团队、场地与修图,新增一个款式就会重复产生整套拍摄成本。
我的方案:先建立固定手模素材库,再让不同 Agent 并行处理款式生成、失败重试、素材整理与 QA,最终批量进入商品页。
先锁定姿态、肤色、构图与品牌基线,后续款式复用同一套基础素材。
任务独立排队、失败单独重试,不让一个异常阻塞整批内容。
INFERENCE方案估算
约 70%–85%相较每个款式都重新组织模特、摄影、场地与修图的传统方案,预计降低的内容制作成本。待财务账单交叉验证。
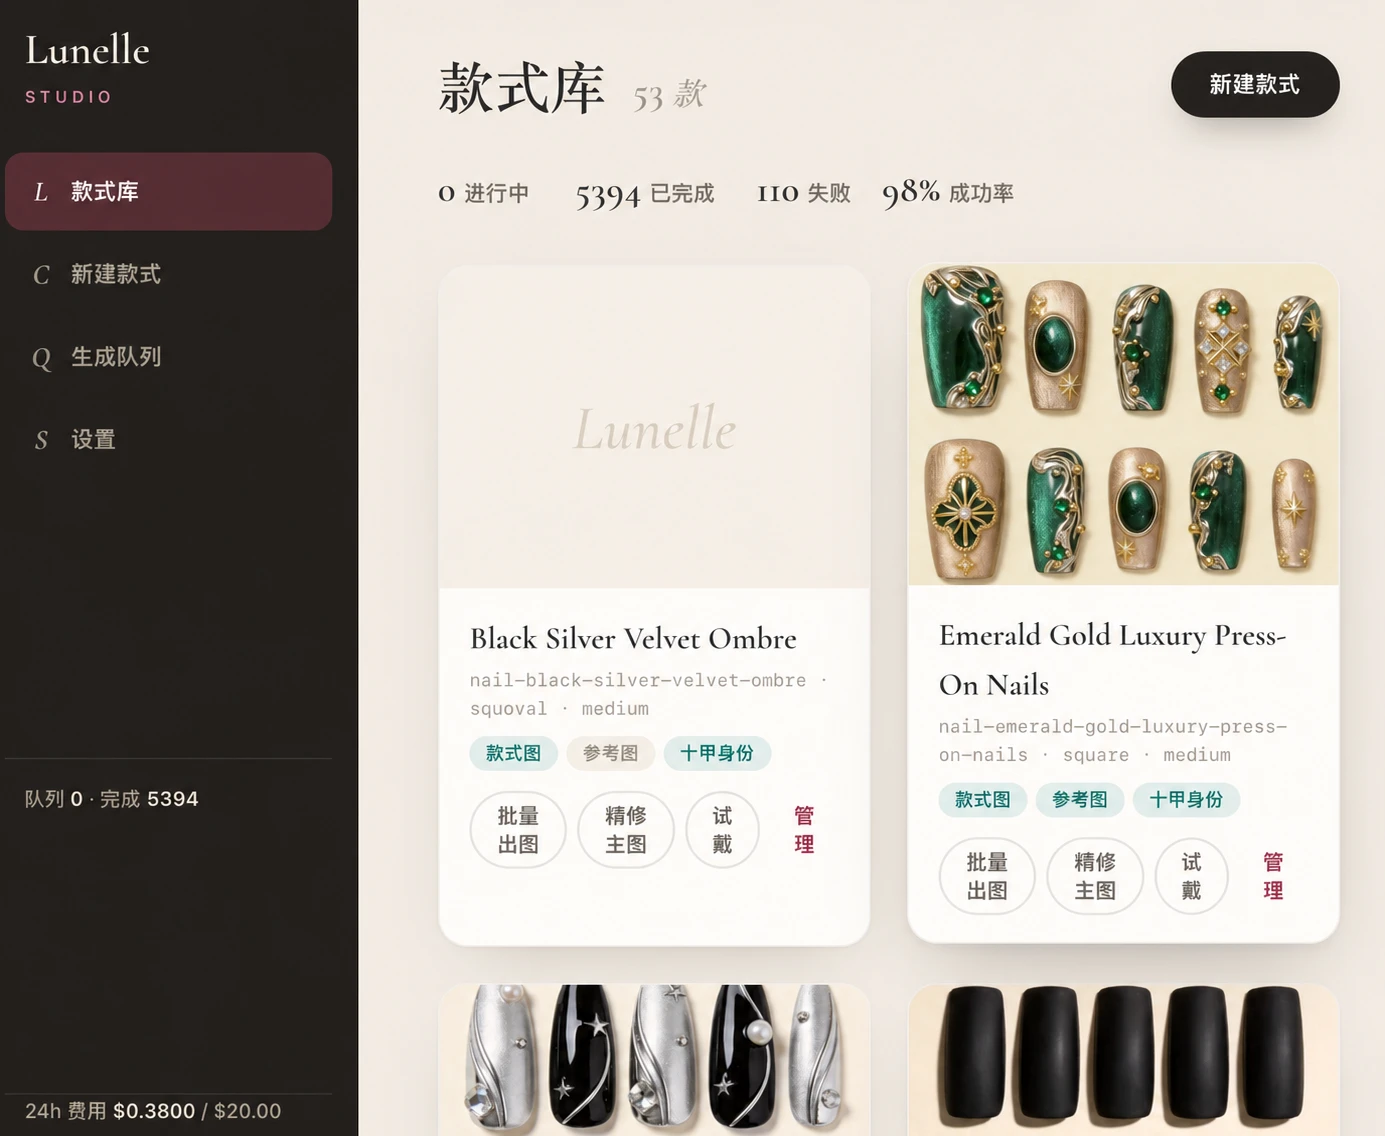
01需求确认02流程设计03批量执行04失败重试05人工 QA06页面交付
03 / 我的工作方法返回岗位证据 ↑
同一个任务,
两种完全不同的工作流。
点击切换,看传统长对话与我的分工式工作流,差别具体发生在哪里。
一个 Agent,背着全部上下文往前跑看起来省步骤,实际把理解、执行和验收混在一起。
对话越来越长,Agent 同时扮演分析者、执行者和验收者。反复压缩后,早期约束被稀释;一旦失败,只能回查整段历史。
AS-IS传统工作流
- 01塞入全部上下文
信息多,但没有角色边界。
- 02同一 Agent 分析并修改
判断与执行互相污染。
- 03持续追加对话
压缩后容易缺失早期事实。
- 04相信完成声明
执行者同时验证自己。
- 05失败后整体返工
定位慢,修改半径不可控。
让 AI 商品图从一次性生成,
变成可追踪的生产系统。
挑战:单次调用图像模型能得到一张图,却无法回答 Prompt 版本、失败重试、成本、发布批准与结果复现。
我的角色:定义业务问题与验收标准,拆分任务,控制 Agent 边界,推动审查、回归、人工 QA 与交接。
结果:把一次生成重构为一条可追踪、可恢复、可控成本、经人工批准才发布的生产链路。
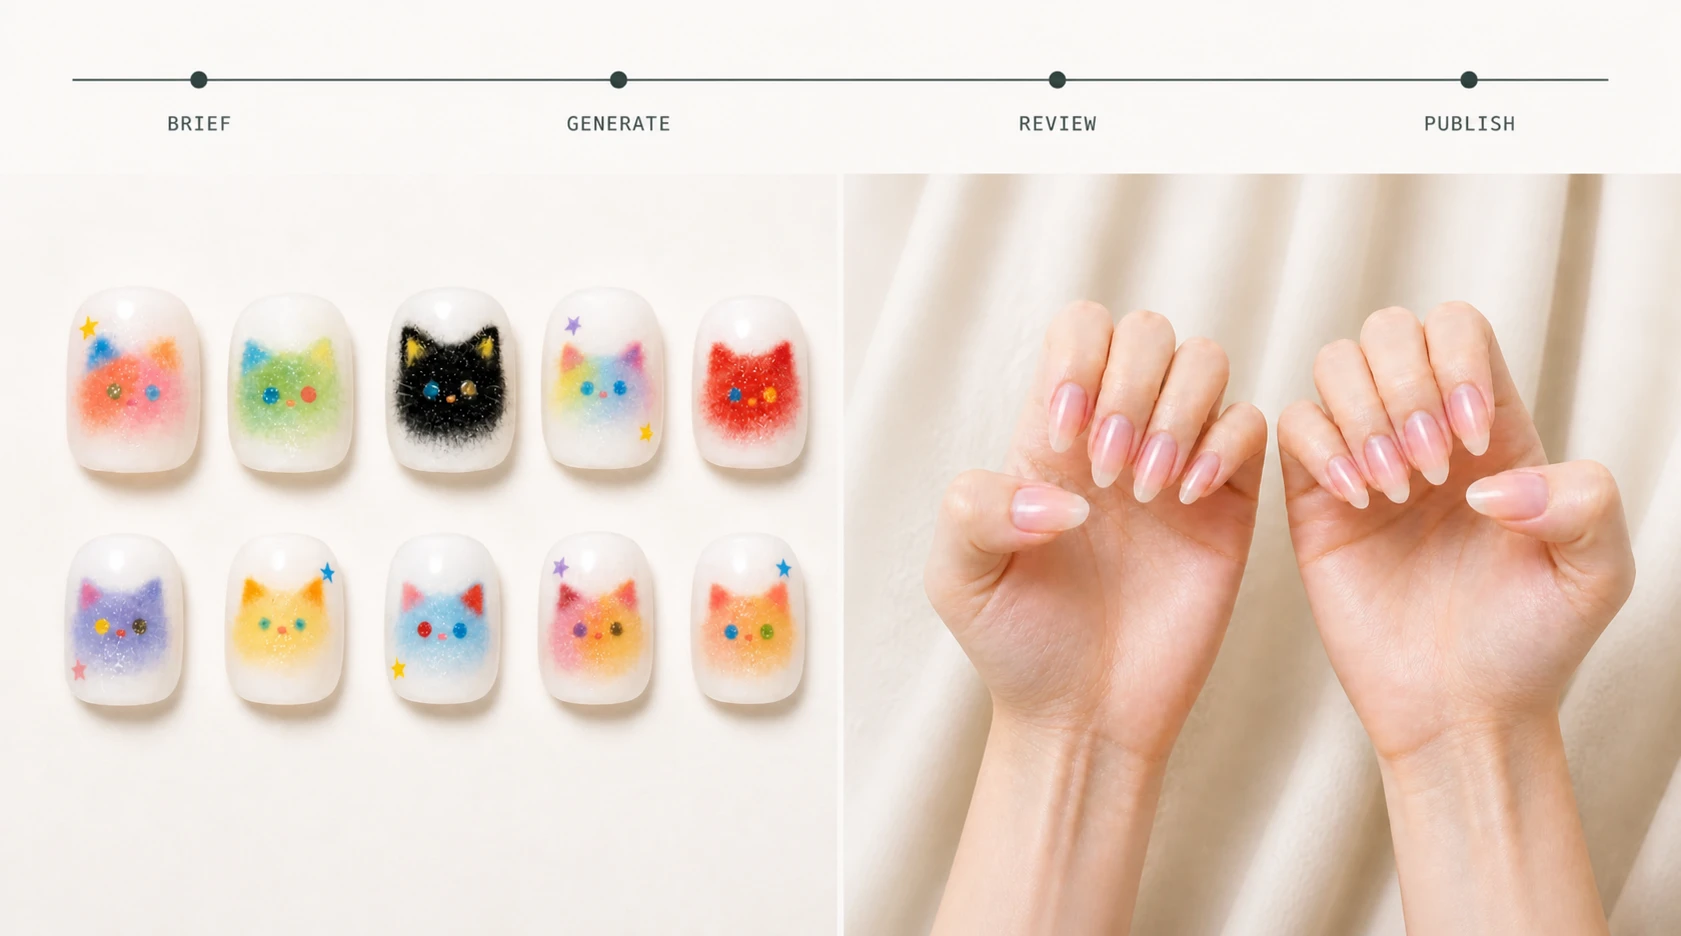
生产流程 / 固定手模与批量款式资产EVIDENCE F-008
我的判断 / PRODUCTION PATH
真正的问题不在生成,
而在生成之后谁对结果负责。
因此我把交付拆成八个关口:输入和 Prompt 先形成可复现任务,状态机接管失败与重试,自动 QA 检查规则,人工 QA 负责视觉判断,最后才允许发布。
01输入需求 · 素材
02Prompt模板 · 版本
03生成模型执行
04任务状态成功 · 重试
05自动 QA规则检查
06人工 QA视觉终审
07导出结构化资产
08发布人工批准
关键决策 / KEY DECISIONS
最重要的不是多一个 Agent,
而是让每个 Agent 只做一件事。
上下文是有限的。与其让一个 Agent 在长对话里反复切换角色,我把守门、分析、执行与验收拆开,让它们共享事实,但不共享混乱的记忆。
Prompt 也需要版本。
生成文本只有一个出口;每个任务持久化版本号。
改词必须升版,避免“同一任务名、不同生成逻辑”。
prompts.py
EVIDENCE F-004PROMPT_VERSION = "pv-3"task.prompt_version → persisted一个 Agent,只做一件事。
看大门的只判断任务能不能进入;分析的只找问题;执行的只在锁定范围内修改;QA 不替执行者自证正确。
GATE守门ANALYZE分析BUILD执行QA验收
EVIDENCE F-005 · F-011上下文不共享记忆,只共享事实。
长对话反复压缩会造成约束缺失和“失忆”。每个 Agent 只接收完成当前职责所需的最小上下文,结束时输出 Fact Snapshot。
最小上下文→单一任务→事实快照
EVIDENCE F-004 · F-011默认拒绝发布。
只有任务成功、确定性 QA 通过、人工明确批准同时成立,资产才进入导出与发布路径。
SUCCESS+QA PASSED+HUMAN APPROVED=SHIP
EVIDENCE F-007现在是什么状态
本轮处理什么
绝对不能改变什么
结论依据在哪里
怎样才算完成
下一位需要知道什么
5 个工作模板
以下是根据真实工作思想重新整理的模板,不伪装成历史原文。
01项目导入与只读审计工作模板+
附件为当前项目。本轮只导入上下文:全面审计现有功能、架构、数据流与运行状态,识别 P0 / P1 问题及未来演进空间。禁止修改任何文件。所有判断必须区分 VERIFIED、INFERENCE 与 UNKNOWN,并为每个问题给出证据位置。
02单一 P0 问题修复工作模板+
本轮只处理一个 P0:{问题}。允许修改:{范围}。禁止修改:{不可变区域}。先复现并记录证据,再提出最小修复;完成后运行 {回归集合}。验收条件:{可观察结果}。若证据不足,停止并返回 UNKNOWN,不得猜测完成。
03对抗式完成审查工作模板+
不要相信‘已经完成’。以审计者身份主动寻找反例:边界输入、失败恢复、并发状态、费用逃逸、旧版本漂移和人工闸门绕过。只报告有证据的问题,按 P0 / P1 / P2 分级,并标明复现条件与最小证据。
04真实 API 实验预算工作模板+
实验目标:{唯一假设}。最大尝试:{N} 次;预算上限:{金额};每次调用前必须明确输入版本。停止条件:达到预算、连续 {N} 次失败、输出无法形成独立证据。成功判定:{量化标准}。实验结束必须记录有效、无效与未验证结论。
05Fact Snapshot 交接工作模板+
生成可复现的 Fact Snapshot:已完成、已验证、未完成、未验证、当前风险、不可变约束、证据位置、工作树状态与下一步。严禁把计划写成完成,把文档声明写成运行事实,把旧测试写成当前测试。
05 / 作品证据附录
我说过的每个重要结论,
都应该能追溯。
默认只展示 4 条代表证据;需要时再查看完整账本。
F-002VERIFIED
交接记录保留了一次 539 passed、2 skipped 的自动化测试结果。
F-004VERIFIED
Prompt 由单一模块生成,任务持久化 prompt_version,文案变更要求升版。
F-007VERIFIED
发布闸门默认拒绝;成功、自动 QA 与人工批准必须同时成立。
F-009VERIFIED
FINGLOW · 芬格露项目覆盖 50+ SKU、5000+ 生成任务、4900+ 成功任务。
一次 $0.76 的 A/B 测试无效。
worker 早于新代码启动,实际输入与冻结 Prompt 不匹配。
这次结果被判为“未验证任何东西”,没有包装成成功。
QA 通过,仍可能视觉错误。
heuristic QA 曾 4/4 全部通过,但人工摆位检查仍接近随机基线。
视觉结果必须保留人工终审。
539 项测试 ≠ 真实 API 全通过。
mock provider 能证明自动化覆盖记录,不能替代真实生产验证。
EVIDENCE F-002版本名正确,进程仍可能过期。
交接快照中的 5 条硬约束有 3 条当时未满足;未提交变更也不能被提前写成“已经关闭”。
HANDOFF §12–13